文献工作台 · 本地论文库研究助手
2026.05 – 至今。撰写学术论文时,文献多半已经在本地。接下来要判断这批 PDF 能不能撑住当前任务。系统只在用户入库的文献里取证,按开题至结题出工作稿;依据不够就写「未找到依据」,不代写正文。
背景与目标
撰写学术论文时,文献多半已经入库。要判断的是这批 PDF 能不能撑住当前任务。现有工具把「发现尚未阅读的论文」和「使用已经入库的论文」放在同一套问答里。模型会用训练语料补全,用户分不清句子来自本地文献还是模型记忆。开题、综述、方法、写作、结题对合格答案的要求不同,通用问答却只有一种输出。
交付物:在用户自己的 PDF 库内,按研究阶段给出有出处、可拒答、不代写的工作稿。用户据此决定继续用这批文献、补文献,或改问题。
| 用户侧结果 | 验收标准 |
|---|---|
| 不把库外记忆写成结论 | 库中无对应结论时输出「未找到依据」,不得编造文献 |
| 当前任务拿到对应工作稿,而不是一篇代写 | 开题说明覆盖与缺口,综述做对照,方法拆解做法,写作核对事实与数字,结题整理可回溯的原话 |
| 每一句能指回自己的 PDF | 每条引用须指向本轮命中文献的标题、章节与页码 |
| 结果可复跑、可分开记 | 20 题可重复运行,换语料、换生成、换界面的结果分开记录 |
范围上明确排除:不代替用户发现新论文;不代写开题报告、文献综述、方法章节或论文正文;不以款式图作为检索对象;扫描件若无文字层,标注为空,不将识别结果伪装成已通读。
定位
知网与 Elicit 解决「还有哪些论文没读」;NotebookLM 解决「如何把已有材料综合成可读文本」。这里做第三件事:已经收下的 PDF,够不够撑住当前这一步。
只根据用户导入的 PDF 作答,不承担文献发现,不代写正文。发现类产品答不上来,表示需要继续检索;这里答不上来,表示现有库有缺口。评测集里有一道库外题,标准答案是「未找到依据」。
| 知网 CNKI AI | Elicit | NotebookLM | 文献工作台 | |
|---|---|---|---|---|
| 主要场景 | 平台内检索与阅读 | 按研究问题抽取证据 | 理解材料并辅助成稿 | 判断本地库能否支撑当前任务 |
| 知识来源 | 知网收录 | 开放学术索引 | 用户当次上传 | 用户本地 PDF 库 |
| 答不上来意味着 | 再搜 | 换问法 | 仍常综合作答 | 库有缺口 |
| 会不会写成可交的稿 | 偏生成式综述 | 偏结构化抽取 | 偏综合叙述 | 不代写正文 |
| 研究阶段 | 无 | 偏综述与抽取 | 无 | 开题至结题五阶段 |
| 中文设计学文献 | 发现能力强 | 覆盖弱 | 一般 | 以真实本地库验收 |
用户与场景
主要用户为正在撰写学术论文、手头已有数十篇 PDF、并处于开题至结题之间某一阶段的人。次要用户需要本地文献库,不便将全文上传至公有云。当前版本以本机运行为默认形态。
使用过程为:导入既有 PDF,选择当前研究阶段,就覆盖、对照、做法、数字或原话提问,阅读工作稿、引用列表与对应 PDF 页。若系统声明未找到依据,用户再决定补充文献或修改问题,而不是采纳一段流畅但无出处的表述。
| 阶段 | 用户任务 | 预期产出 | 应避免的产出 |
|---|---|---|---|
| 开题 | 判断研究方向能否成立 | 说明库中已覆盖的框架与要素,并标出缺口 | 生成开题报告 |
| 综述 | 对照既有文献的立场 | 归纳异同与边界,并标注出处 | 可直接粘贴的 Related Work |
| 方法 | 寻找可借鉴的做法 | 整理步骤、分类与工艺,不提出新方法 | 直接给出新的技术方案 |
| 写作 | 核对事实、数字与出处 | 一句可引用事实及其页码 | 扩写为论文正文 |
| 结题 | 准备答辩表述 | 可回溯至原文的要点;没有则明确说明 | 用无关段落勉强作答 |
方案
五个阶段描述当前写作任务。同一批 PDF 下,切换阶段只改变取证重点与输出结构,不会从外部补文献。时间范围通常已在下载前筛过,主界面默认不提供年份控件。
检索采用 BM25(关键词)与向量(语义)混合,再用 RRF 按名次融合,以便专名、数字和近义提问都能进入名单。当前语义一路仍为 hash 嵌入,只能占位,不能代表近义排序已经成立。生成之后做引用校验:本轮未命中的文献不得进入引用。若无足够依据,先声明未找到,再说明命中文本实际讨论的内容。可信度优先于流畅度。写作阶段只提供可引用事实,不输出可直接作为论文正文的长段落。
已实现能力包括:PDF 上传与管理、无文字层标注、分阶段工作稿、出处须来自本轮用到的文献、以 PDF 原页展示依据。自动撰写综述、看图检索、与知网实时同步,不在本阶段范围之内。
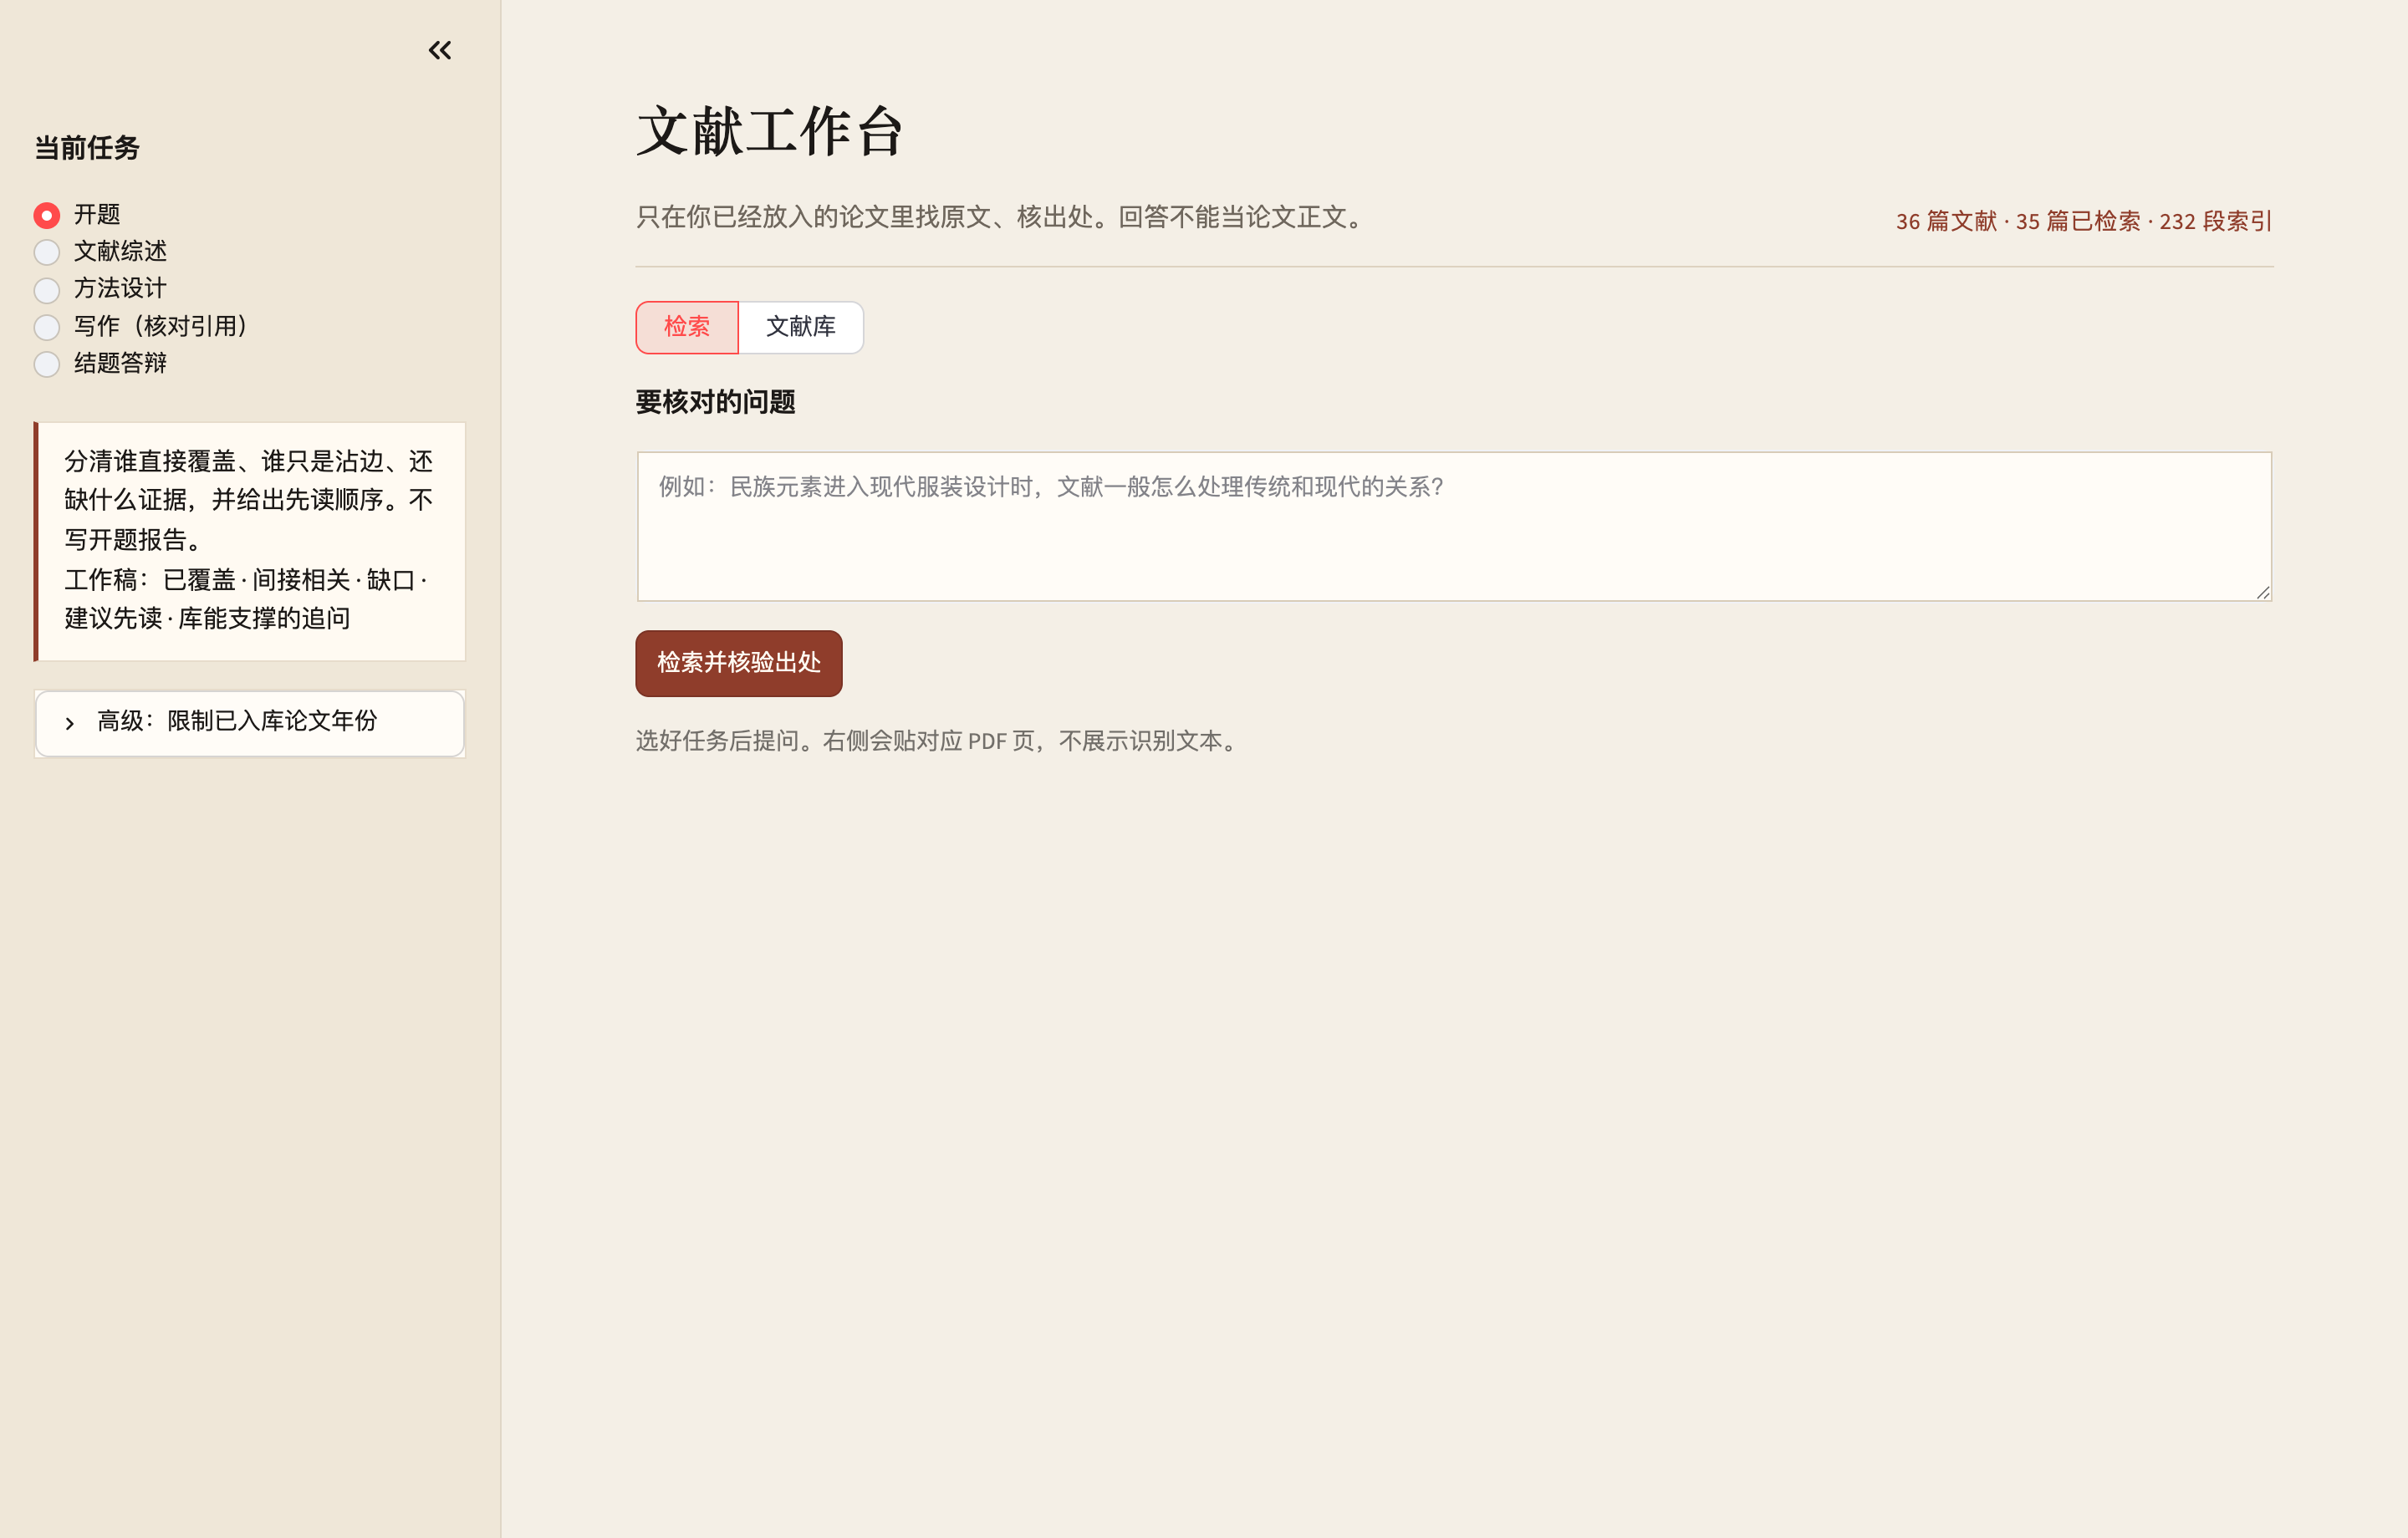
工作台:左侧选择当前任务,中部输入问题,命中后右侧展示对应 PDF 页。
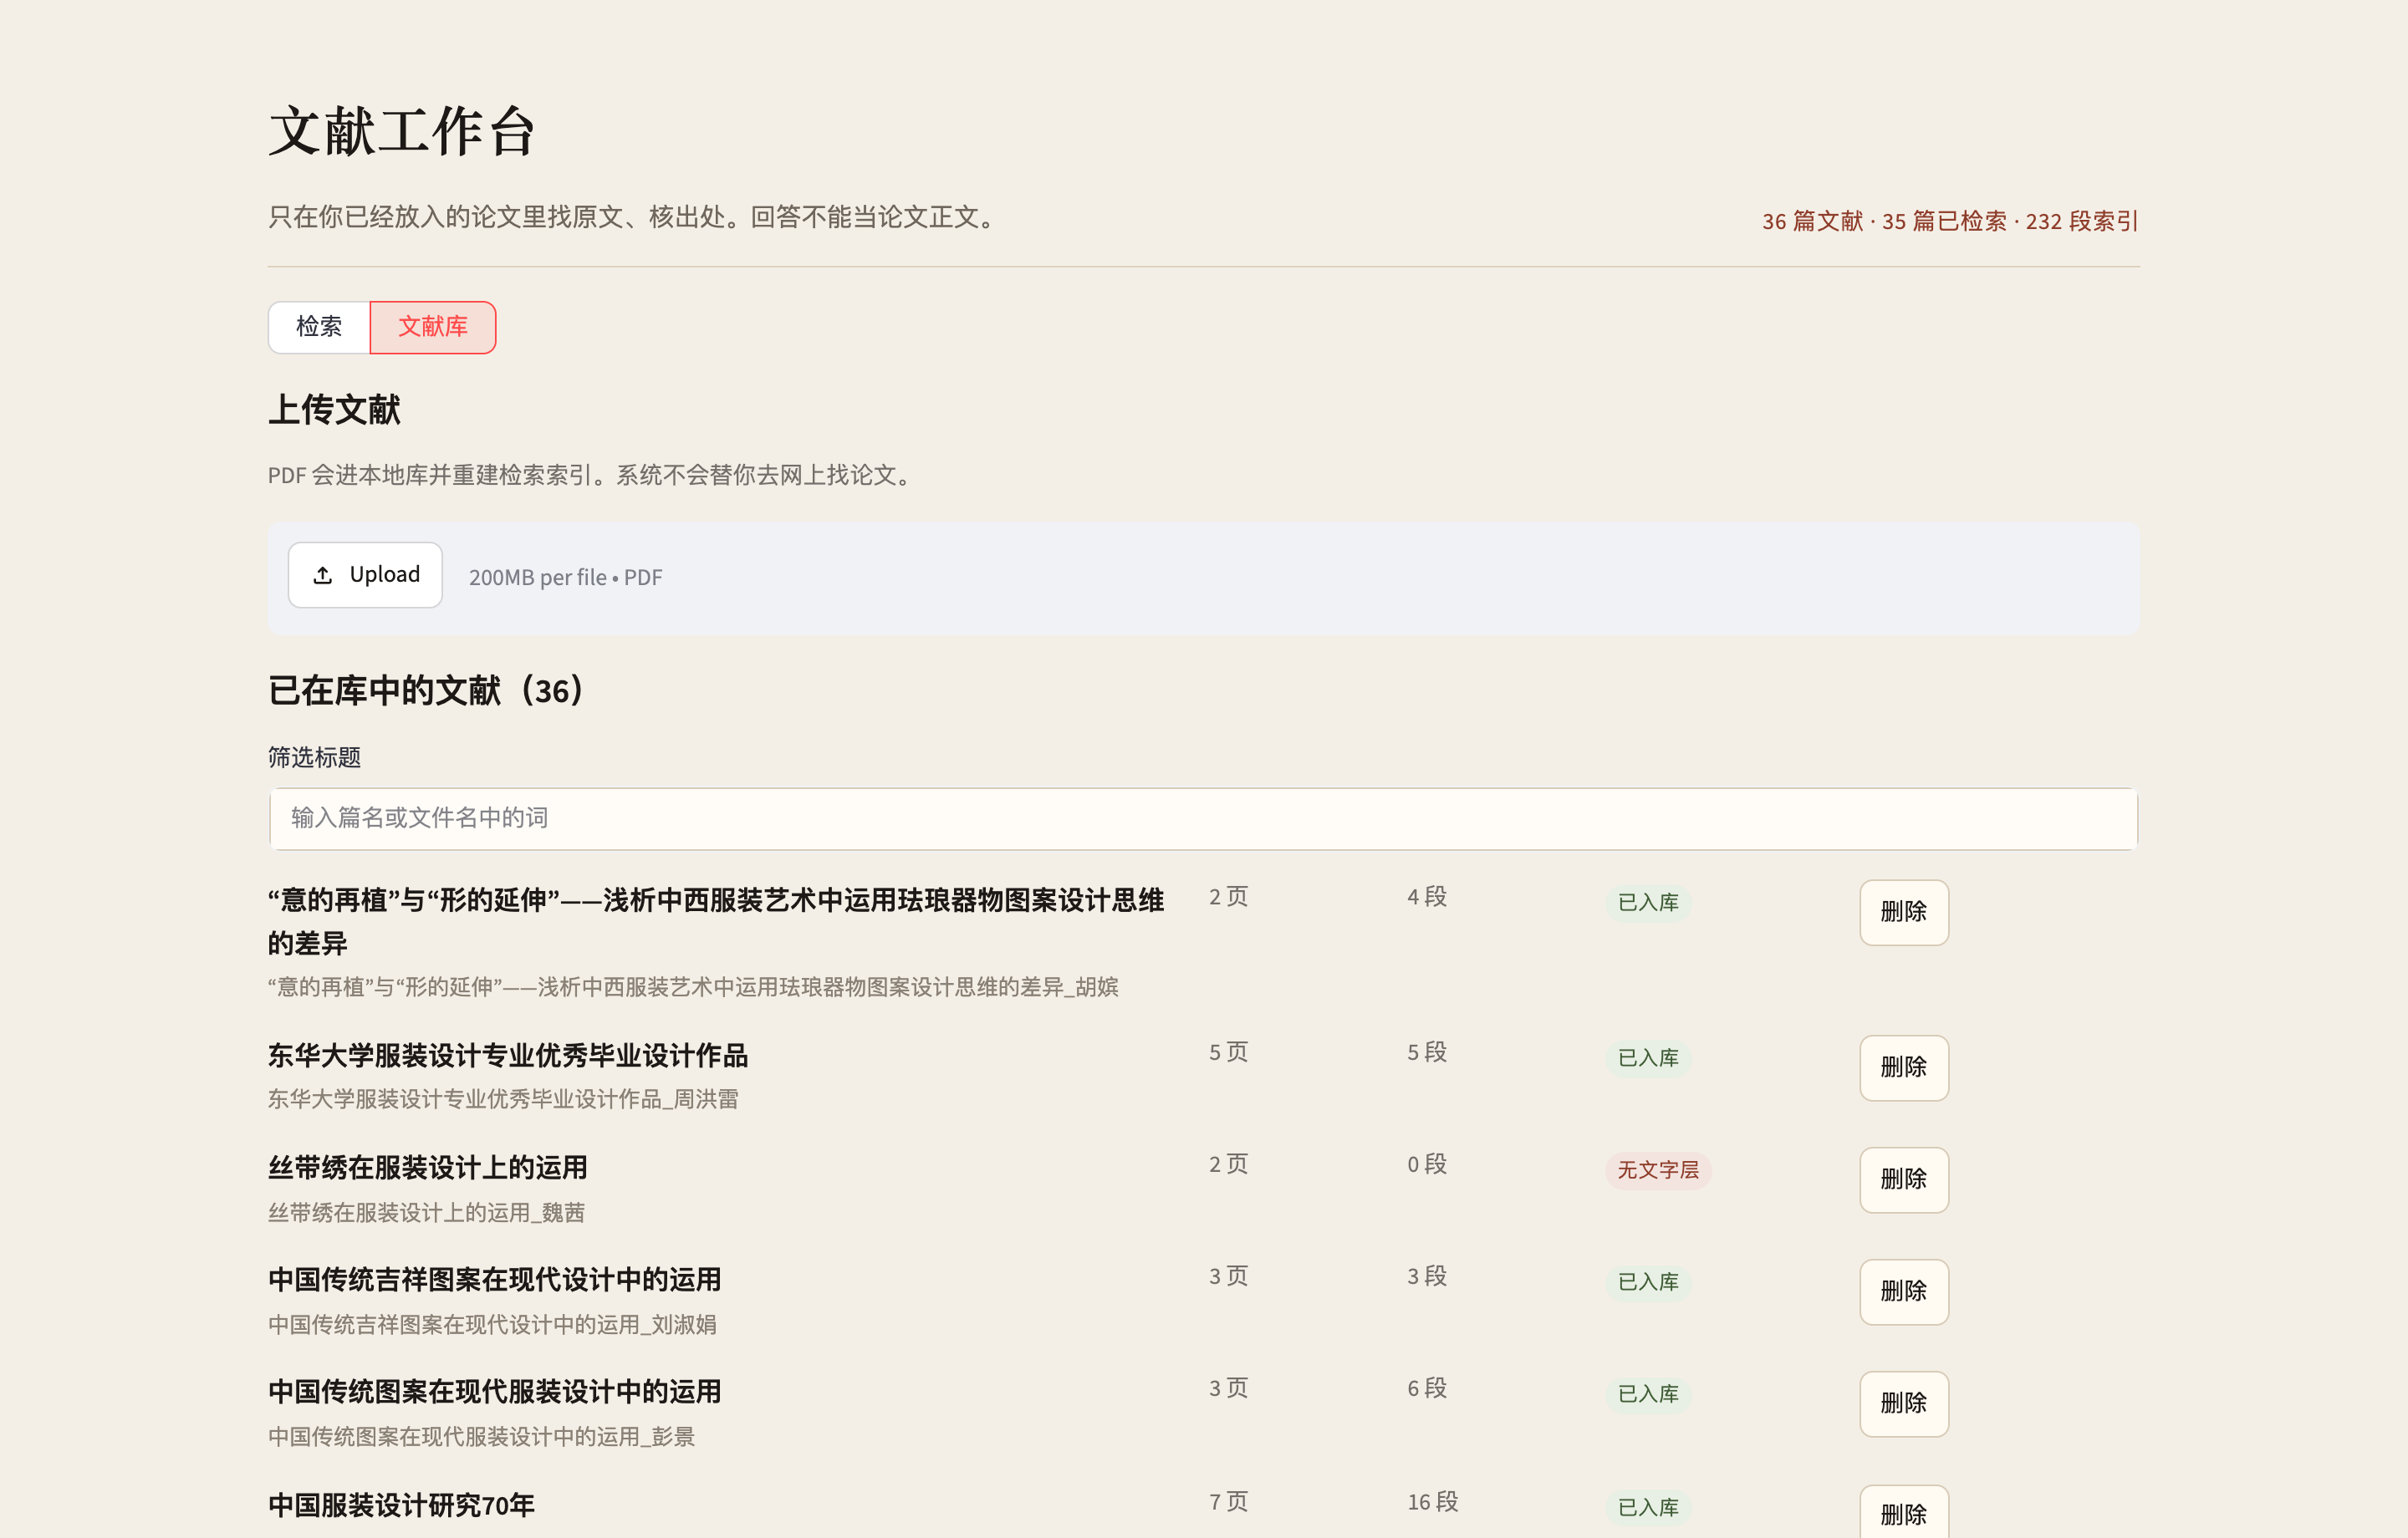
文献库:支持上传、筛选与删除。无文字层的扫描件单独标注,不视为已入库文本。
评测
评测集先于调整生成完成。共 20 题,覆盖五个阶段、四档难度。Level 1 接近标题或摘要用语,Level 2 为同义改写,Level 3 为近义(少专名),Level 4 含跨篇综合、数字核对,以及库中不存在对应结论的负例。每题绑定金标文献;负例 defense-l4 的金标为空,期望输出「未找到依据」。
| 指标 | 含义 | 当前结果 |
|---|---|---|
| 文档召回 | 目标文献是否进入 Top-10 | 1.00 |
| nDCG@10 | 目标文献的排序质量 | 0.89 |
| 忠实度 | 答案与命中片段的词重叠估计;非 RAGAS | 0.82 |
| 引用可追溯 | 所列引用是否均能指回本轮检索结果 | 1.00 |
样例库与真实论文库使用不同题目,分数不得横向比较。需要单独观察:defense-l4 必须整题拒答;proposal-l3(「服装如何讲故事」)召回 1.00、nDCG 0.29;写作题中的 70.7%、83% 须与原文一致。题目与分表见 评测结果,完整问答见 问答实例。
项目文档
围绕上述定位形成一套可复用文档,可分别打开:
- 一页纸概览:问题、用户、已交付、短板
- 产品需求文档:目标、场景、功能、验收与迭代
- 竞品分析:按用户任务切品类,不比收录规模
- 评测集设计说明:题集结构、指标口径
- 评测结果:分阶段、分难度分数与 20 题一览
- 迭代记录:每轮改了哪类条件;样例库与真库分数分开记
- 技术方案说明:检索、拒答、阶段策略
- 问答实例集:对照、拒答与缺口三类案例
迭代
每次实验只改一类条件。样例库只证明链路可跑,不能当正式结论。换成 35 篇真实论文并重写 20 题后,抽取式不可读,负例会编造,近义题 nDCG 只有 0.29。随后在同一索引与同一套题上只开 LLM + 引用校验:表述可读,负例拒答,引用可追溯仍为 1.00;近义排序没有改善,问题在嵌入。文献库管理、隐藏年份、展示 PDF 原页单独做,不拿来解释检索分数。
| 轮次 | 改了哪类条件 | 结果 |
|---|---|---|
| v0 | 样例库 + BM25/向量/RRF,把提问链路跑通 | 可运行,不能外推到真实语料 |
| v1-hash 抽取式 | 35 篇论文与新 20 题 | 召回高,但不可读;负例未拒答 |
| v1-real-llm | 同一索引,只开 LLM + 引用校验 | 1.00 / 0.89 / 0.82 / 1.00;负例拒答;proposal-l3 nDCG 仍为 0.29 |
| 界面与文献库 | 隐藏年份、工作稿结构、原页展示 | 改善使用体验,不改变检索实验口径 |
| R3 | 只换嵌入(BGE-M3 或 OpenAI) | 尚未进行 |
短板与下一步
五个阶段目前的差异主要在生成模板。中文期刊大量落在 front-matter。近义题「服装如何讲故事」金标已进 Top-10,nDCG 0.29,这是 hash 嵌入的典型结果。开题案例里,结论已写明只覆盖一篇,缺口栏却记为「未发现」。
下一步仍只改一类条件:先换嵌入,题集不动;再做中文章节结构化,验收看五阶段命中章节的分布有没有分开。这两步之前不接外部发现,也不做看图检索。